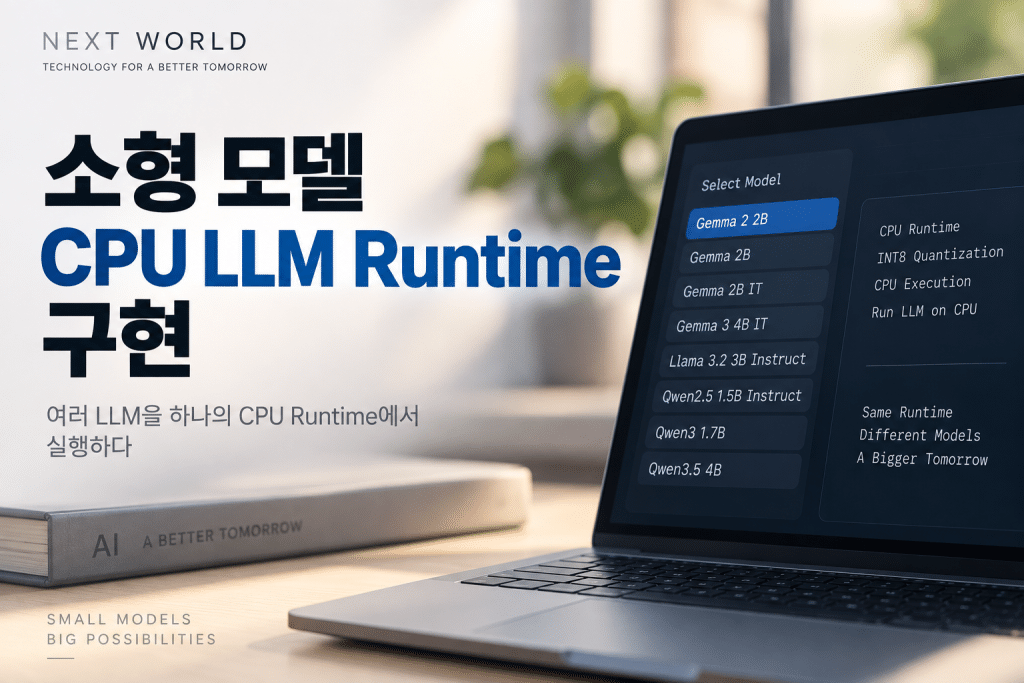
LLM을 직접 개발한 CPU LLM Runtime에서 여러 소형 모델을 하나씩 테스트해봤다. 이번 테스트의 목적은 특정 모델 하나의 성능을 확인하는 것이 아니라, 서로 다른 모델을 하나의 Runtime에서 실제로 실행할 수 있는지 확인하는 것이다.
현재 Runtime에는 Gemma, Llama, Qwen 계열의 여러 모델이 등록되어 있으며 모델을 선택해 직접 실행할 수 있다.
소형 LLM을 CPU LLM Runtime에서 실행하다
처음에는 작은 모델 하나를 CPU에서 실행하는 것부터 시작했지만 Runtime이 발전하면서 테스트 대상도 자연스럽게 늘어났다.
GPU 가속 없이 CPU만으로 모델을 로딩하고, Tensor를 구성하고, 실제 토큰을 생성하는 전체 과정을 CPU LLM Runtime을 개발하며 직접 확인했다.
단순히 모델이 로딩되는 것과 실제 추론이 정상적으로 진행되는 것은 다른 문제이기 때문에 각각의 과정을 확인하는 것이 중요했다.
실제 테스트에서는 6개 CPU 스레드와 CPU Execution 구조를 사용해 모델 로딩부터 토큰 생성까지 직접 실행했다.
이번 테스트에 사용한 LLM 모델들
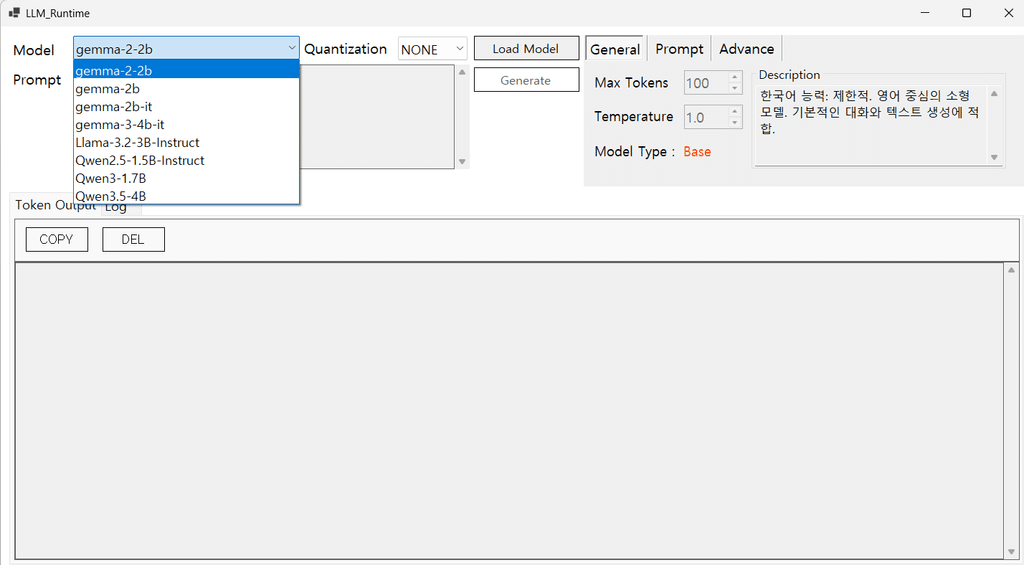
현재 테스트 화면에는 Gemma 2 2B, Gemma 2B, Gemma 2B IT, Gemma 3 4B IT, Llama 3.2 3B Instruct, Qwen2.5 1.5B Instruct, Qwen3 1.7B, Qwen3.5 4B가 등록되어 있다.
모델의 크기는 약 1.5B부터 4B 수준으로 구성했으며, 서로 다른 모델 계열을 같은 CPU Runtime에서 실행하는 것을 목표로 했다.
이렇게 모델을 다양하게 구성하면 특정 모델에만 맞춰진 Runtime인지, 여러 구조를 처리할 수 있는 Runtime인지도 확인할 수 있다.
현재 Runtime에는 Gemma, Llama, Qwen 계열을 포함한 8개 모델이 등록되어 있어 서로 다른 모델을 동일한 실행 환경에서 테스트할 수 있도록 구성했다.
하나의 Runtime에서 여러 모델을 실행하는 구조
모델을 선택하면 해당 모델의 설정과 가중치를 읽고 Runtime이 필요한 실행 구조를 구성한다.
모델마다 Tensor의 구성이나 Attention 구조 등이 다르기 때문에 단순히 파일 이름만 바꿔서 실행하는 방식으로는 해결되지 않는다.
여러 모델을 지원한다는 것은 서로 다른 모델 구조를 하나의 실행 시스템에서 처리할 수 있도록 만드는 것이다.
SafeTensors로 모델을 읽고 INT8 양자화를 적용한 뒤, CPU Execution Compiler가 CPU 실행 구조를 생성하고 cpu_execution.cache에 이를 저장한다. 이후 실행에서는 생성된 Execution Program을 재사용해 나의 CPU LLM Runtime은 모델을 실행하는 구조까지 구현했다.
모델 크기가 달라지면 실행 성능도 달라질까
소형 모델이라고 하더라도 모델의 크기가 커지면 처리해야 하는 가중치와 연산량이 증가한다.
예를 들어 1.5B급 모델과 4B급 모델을 같은 CPU에서 실행한다면 필요한 계산량과 메모리 접근량에도 차이가 생길 수밖에 없다.
따라서 이번 테스트에서는 단순히 “실행된다”는 결과보다 모델 크기에 따라 실제 실행 특성이 어떻게 달라지는가를 확인하는 데 의미가 있다.
실제 개발 과정에서는 Gemma, Llama, Qwen 계열의 여러 소형 모델을 하나의 CPU LLM Runtime에서 직접 구현하고 실행했다. 모델마다 Transformer Layer와 Tensor 구성, Attention 구조 등이 달랐으며, 이러한 구조적 차이가 CPU에서 처리해야 하는 연산량과 실행 성능에 직접 영향을 준다는 것을 확인했다.
Gemma · Llama · Qwen 모델별 실행 결과
이번 테스트에서 가장 흥미로운 부분은 모델 계열이 바뀌었을 때 Runtime의 동작도 함께 달라진다는 점이다.
Gemma, Llama, Qwen은 모두 LLM이지만 내부 구조가 완전히 동일하지 않기 때문에 Runtime에서는 모델별 특성을 고려해야 한다.
특히 새로운 모델을 추가할 때마다 기존 실행 구조에서 예상하지 못했던 차이가 나타날 수 있어 모델 추가 자체가 Runtime 테스트가 되기도 한다.
Gemma, Llama, Qwen 계열의 여러 모델을 하나씩 구현하면서 모델마다 서로 다른 구조와 Tensor 구성을 직접 CPU LLM Runtime에서 처리해야 했다. 이를 통해 단순히 모델 파일을 추가하는 것이 아니라, 각 모델의 구조적 차이를 Runtime이 이해하고 실행할 수 있도록 확장해야 한다는 것을 확인했다.
CPU 메모리는 실제로 얼마나 사용하는가
CPU Runtime에서는 GPU 메모리 대신 시스템 메모리를 사용하기 때문에 모델 가중치와 실행 과정에서 필요한 메모리를 함께 확인해야 한다.
모델이 로딩된 이후에도 입력과 중간 연산 데이터, Cache 등이 사용되기 때문에 실제 메모리 사용량은 모델 파일 크기와 단순히 일치하지 않는다.
특히 Context가 길어지거나 생성 토큰이 늘어나면 추론 과정에서 CPU LLM Runtime에서는 추가로 필요한 메모리까지 고려해야 한다.
모델을 실행하면서 발견한 CPU 병목
실제 CPU 추론을 진행해보면 단순히 CPU 코어 수가 많다고 해서 모든 연산이 빠르게 처리되는 것은 아니다.
대규모 행렬 연산에서는 연산량 자체뿐 아니라 메모리에서 데이터를 가져오고 다시 저장하는 과정도 상당한 영향을 줄 수 있다.
따라서 Runtime의 성능을 높이려면 단순한 멀티스레드 적용을 넘어 데이터 배치와 메모리 접근 방식까지 살펴봐야 한다.
실제 테스트에서는 모델별로 주요 연산에 소요되는 시간이 서로 다르게 나타났으며, 특정 연산에 실행 시간이 집중되는 현상도 확인했다. 따라서 CPU LLM Runtime의 성능을 높이기 위해서는 단순한 스레드 증가보다 모델별 병목 연산을 찾아 해당 Kernel을 최적화하는 과정이 필요했다.
같은 CPU인데 모델마다 속도가 다른 이유
같은 CPU에서 실행하더라도 모델마다 처리해야 하는 Tensor의 크기와 연산 구조가 다르기 때문에 실행 속도가 동일할 수 없다.
특히 모델의 파라미터 수뿐 아니라 Attention 구조와 각 연산에서 처리하는 데이터량에 따라서도 CPU가 받는 부담이 달라질 수 있다.
그래서 CPU Runtime의 성능을 평가할 때는 모델 이름이나 파라미터 수만 보고 판단하기보다 실제 실행 결과를 측정하는 과정이 필요하다.
같은 CPU에서 실행하더라도 연산별 처리량이 크게 달랐으며, 실제 측정에서도 QKV Projection보다 O Projection과 MLP에서 훨씬 많은 실행 시간이 발생했다.
실행 성공보다 중요한 것은 TPS였다
모델이 정상적으로 로딩되고 답변까지 출력된다고 해서 CPU LLM Runtime개발이 끝나는 것은 아니다.
실제로 사용할 수 있는 Runtime이 되려면 초당 몇 개의 토큰을 생성하는지, 즉 TPS(Token Per Second)를 확인해야 한다.
결국 CPU Runtime 개발의 다음 단계는 여러 모델을 실행하는 것을 넘어 각각의 모델에서 어느 정도의 추론 성능을 확보할 수 있는지 측정하는 것이다.
실제 CPU LLM Runtime 개발할 때 초반 측정 사례로 Qwen3-1.7B에서는 50토큰 생성에 99초 이상이 걸린 실행도 있었으며, 약 0.5 TPS 수준까지 떨어지는 결과가 나타났다. 이 결과는 Runtime이 정상적으로 모델을 실행하는 것과 실사용 가능한 추론 성능을 확보하는 것이 전혀 다른 문제라는 것을 보여준다.
CPU 전용 Runtime의 현재 성능
현재 Runtime은 여러 소형 LLM을 하나의 실행 환경에서 선택하고 로딩할 수 있는 단계까지 발전했다.
Qwen3-1.7B와 같은 모델을 대상으로 실제 CPU 추론을 진행하면서 연산별 병목과 메모리 사용량도 함께 확인하고 있다.
이제부터는 단순한 기능 구현보다 CPU에서 실제로 어느 정도의 TPS를 만들어낼 수 있는가가 중요한 실험 과제가 된다.
현재 Runtime은 단순히 모델을 메모리에 올리는 수준을 넘어 CPU Execution Cache를 생성하고 이후 실행에서 이를 HIT하여 재사용하는 단계까지 구현되어 있다.
이번 테스트에서 확인한 것
이번 테스트에서 확인하고 있는 것은 단순히 “CPU에서도 LLM이 실행된다”는 사실이 아니다.
서로 다른 모델을 하나의 Runtime에서 실행하려면 모델 구조를 해석하고, Tensor를 구성하고, 각 연산을 연결하는 과정이 필요하다는 것을 실제 개발 과정에서 확인할 수 있었다.
그리고 모델이 다양해질수록 Runtime 자체의 구조와 확장성이 더욱 중요해진다는 점도 확인하고 있다.
이번 실험을 통해 CPU Runtime에서는 단순한 모델 로딩 성공보다 추론 실행 구조를 얼마나 세밀하게 설계하고 각 단계의 병목을 얼마나 효과적으로 제거하느냐가 실제 성능을 결정한다는 것을 확인했다.
추론 과정을 더 세분화할수록 성능을 개선할 수 있는 포인트는 많아진다. 하지만 그만큼 각각의 연산과 메모리 흐름까지 직접 구현하고 최적화해야 하기 때문에 성능을 높일수록 Runtime 자체의 구현 난이도와 개발 공수도 함께 커진다.
다음 목표는 CPU 추론 성능 최적화
현재 단계에서는 여러 모델을 하나의 CPU Runtime에서 실행하는 것에서 한 단계 더 나아가 실제 추론 성능을 높이는 작업이 필요하다.
멀티코어 활용, SIMD 연산, 메모리 접근, Tensor 처리 방식 등을 개선하면서 모델별 TPS가 얼마나 달라지는지 계속 확인할 계획이다.
하지만 이번에 여러 모델을 직접 구현하고 테스트하면서 예상하지 못했던 문제도 확인했다.
같은 계열의 모델이라도 버전에 따라 구조와 연산 방식이 달라질 수 있고, 모델이 달라지면 Runtime에서 처리해야 할 부분도 크게 달라진다.
결국 모든 모델과 모든 버전을 하나의 Runtime에서 동일한 수준으로 최적화하려면 지원 범위가 넓어질수록 개발과 유지보수에 필요한 공수도 함께 증가한다.
특히 CPU에서 높은 성능을 목표로 할 경우 단순한 호환성 확보를 넘어 모델별 연산 구조에 맞춘 최적화가 필요하기 때문이다.
이번 테스트를 통해 모든 모델을 폭넓게 지원하는 것과 특정 모델의 성능을 깊게 최적화하는 것 사이에는 분명한 개발 비용의 차이가 있다는 것도 확인했다.
따라서 앞으로는 모든 모델을 무작정 지원하기보다 실제로 자주 사용될 가능성이 높은 특정 모델을 선정하고, 해당 모델에 Runtime을 특화하는 방향으로 개발을 진행할 예정이다.
결국 이번 테스트는 단순히 여러 모델을 실행해 본 것이 아니라, CPU 전용 Runtime을 어떤 방향으로 발전시켜야 하는지를 결정한 실험이기도 했다.
[글에서 사용한 머리 아픈 용어]
- Runtime(추론 런타임): 학습이 끝난 AI 모델을 실제 하드웨어에서 실행할 수 있도록 모델 로딩, 연산, 메모리 관리, 실행 과정 등을 담당하는 소프트웨어 환경입니다.
- CPU Execution: AI 모델의 연산을 GPU 가속 없이 CPU에서 직접 수행하도록 구성한 실행 구조입니다. CPU의 코어와 메모리, 연산 특성에 맞춰 데이터를 처리합니다.
- Tensor(텐서): AI에서 사용하는 다차원 숫자 배열입니다. 모델의 가중치와 입력 데이터, 중간 연산 결과 등이 Tensor 형태로 처리됩니다.
- SafeTensors: AI 모델의 가중치를 안전하고 효율적으로 저장하기 위해 사용하는 모델 파일 형식입니다. Runtime에서는 이 파일을 읽어 모델의 Tensor와 가중치를 구성합니다.
- Quantization(양자화): 모델의 가중치를 더 작은 데이터 형식으로 변환해 메모리 사용량과 연산 부담을 줄이는 기술입니다. 이번 Runtime에서는 INT8 양자화를 적용했습니다.
- CPU Execution Compiler: 모델의 Tensor와 연산 구조를 CPU에서 실행할 수 있는 형태로 변환하고 실행 구조를 생성하는 구성 요소입니다.
- Kernel(커널): 실제 하드웨어에서 특정 연산을 수행하는 실행 코드입니다. 행렬곱이나 벡터 연산 등을 CPU에 맞게 최적화해 실행합니다.
- TPS(Token Per Second): LLM이 1초 동안 생성할 수 있는 토큰 수를 나타내는 지표입니다. CPU Runtime의 실제 추론 속도를 확인하는 데 사용됩니다.
- SIMD: 하나의 명령어로 여러 데이터를 동시에 처리하는 CPU의 병렬 연산 방식입니다. CPU에서 행렬이나 벡터 연산을 빠르게 처리하는 데 활용됩니다.
※ 특정 산업이나 자산에 대한 투자 판단은 본인의 책임 하에 신중히 결정하시기 바랍니다.